在上一部分中,我們探討了阿里內部海量數據處理系統(tǒng)的需求、挑戰(zhàn)以及核心技術組件。本部分將深入分析其整體架構設計、數據服務創(chuàng)新,以及阿里如何通過自研和開源技術推動數據處理服務的發(fā)展。
一、整體架構設計
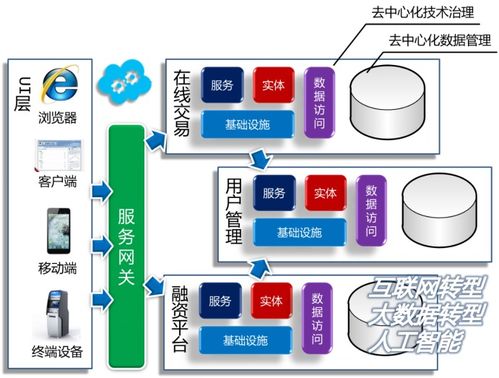
阿里內部海量數據處理系統(tǒng)采用了分層架構,以確保高擴展性、可靠性和效率。主要分層包括:
- 數據采集層:通過DataX、Logtail等工具實現多源異構數據的實時和批量采集,支持日志、數據庫、流數據等。
- 存儲層:基于分布式存儲系統(tǒng)如HDFS、阿里云OSS,結合自研的盤古和表格存儲(OTS),提供高吞吐和低延遲的存儲能力。
- 計算層:整合批處理和流計算,使用MaxCompute(原ODPS)處理離線數據,Flink和Blink支持實時流處理,確保數據處理的靈活性和實時性。
- 服務層:通過DataWorks、AnalyticDB等平臺,提供數據開發(fā)、管理和分析服務,支持用戶快速構建數據應用。
這種分層架構實現了數據處理的高內聚和低耦合,便于模塊化擴展和維護。例如,在雙11等大促場景中,系統(tǒng)通過彈性伸縮和資源調度(如Fuxi調度器)應對峰值負載,確保服務穩(wěn)定性。
二、數據處理服務的創(chuàng)新
阿里在數據處理服務上的創(chuàng)新主要體現在以下幾個方面:
- 統(tǒng)一數據服務平臺:通過OneData方法論,實現了數據標準化和資產化管理,減少了數據冗余和重復計算。阿里內部產品如淘寶、支付寶等共享統(tǒng)一的數據服務,提升了數據一致性和復用率。
- 實時與離線一體化:借助Flink和MaxCompute的融合,阿里構建了流批一體的數據處理引擎。例如,在推薦系統(tǒng)中,實時用戶行為數據與離線模型數據結合,實現動態(tài)優(yōu)化,提升了用戶體驗。
- 智能化數據治理:引入AI技術進行數據質量監(jiān)控和自動優(yōu)化,例如通過機器學習檢測數據異常,自動修復數據問題,降低了人工干預成本。
- 開源與自研結合:阿里積極開源內部技術,如Flink、Druid等,同時自研了盤古、Fuxi等核心組件,形成了生態(tài)閉環(huán)。這不僅推動了行業(yè)進步,也反哺了內部系統(tǒng)的優(yōu)化。
- 云原生數據處理:隨著阿里云的發(fā)展,數據處理服務逐步遷移到云原生架構,利用容器化和Serverless技術,實現資源的按需分配和成本優(yōu)化。
三、案例:從淘寶到全場景應用
以淘寶為例,數據處理系統(tǒng)每天處理PB級數據,支撐搜索、推薦、風控等核心業(yè)務。通過架構創(chuàng)新,淘寶實現了:
- 實時用戶畫像更新,毫秒級響應推薦請求。
- 離線數據挖掘,助力商家進行銷售預測和庫存管理。
- 數據服務API化,讓業(yè)務方快速調用數據,縮短開發(fā)周期。
阿里將這一架構推廣到金融、物流等場景,形成了通用的數據處理解決方案,體現了其可復制性和適應性。
四、總結與展望
阿里的海量數據處理系統(tǒng)設計,不僅解決了內部業(yè)務的高并發(fā)和數據多樣性挑戰(zhàn),還通過架構優(yōu)化和服務創(chuàng)新,為行業(yè)樹立了標桿。隨著5G和物聯網的普及,數據處理將面臨更大規(guī)模和實時性要求。阿里正探索邊緣計算、聯邦學習等新技術,以構建更智能、高效的數據處理生態(tài)。
從阿里內部產品可以看出,海量數據處理系統(tǒng)的成功關鍵在于:分層架構的靈活性、實時與離線的融合、智能化治理,以及開源與自研的協(xié)同。這些經驗為其他企業(yè)提供了寶貴參考,推動數據處理技術不斷向前發(fā)展。